Коли AI потрібен не для розмови
Є задачі, де не треба нова відповідь щоразу. Треба багато разів ухвалити одне й те саме невелике рішення: ця заявка гаряча чи ні, цей відгук містить скаргу чи питання, ця фраза підходить до категорії чи ні.
Людина може пройти такий список руками. На десятій картці правила ще чіткі. На двохсотій вони вже трохи пливуть. Один прикордонний випадок здається схожим на попередній, інший раптом хочеться оцінити за іншим критерієм.
Саме тут мені цікавий Jev. Не як ще один чат, якому треба щоразу пояснювати контекст. А як вузький суддя для масиву однотипних записів.
Що таке Jev без обгортки
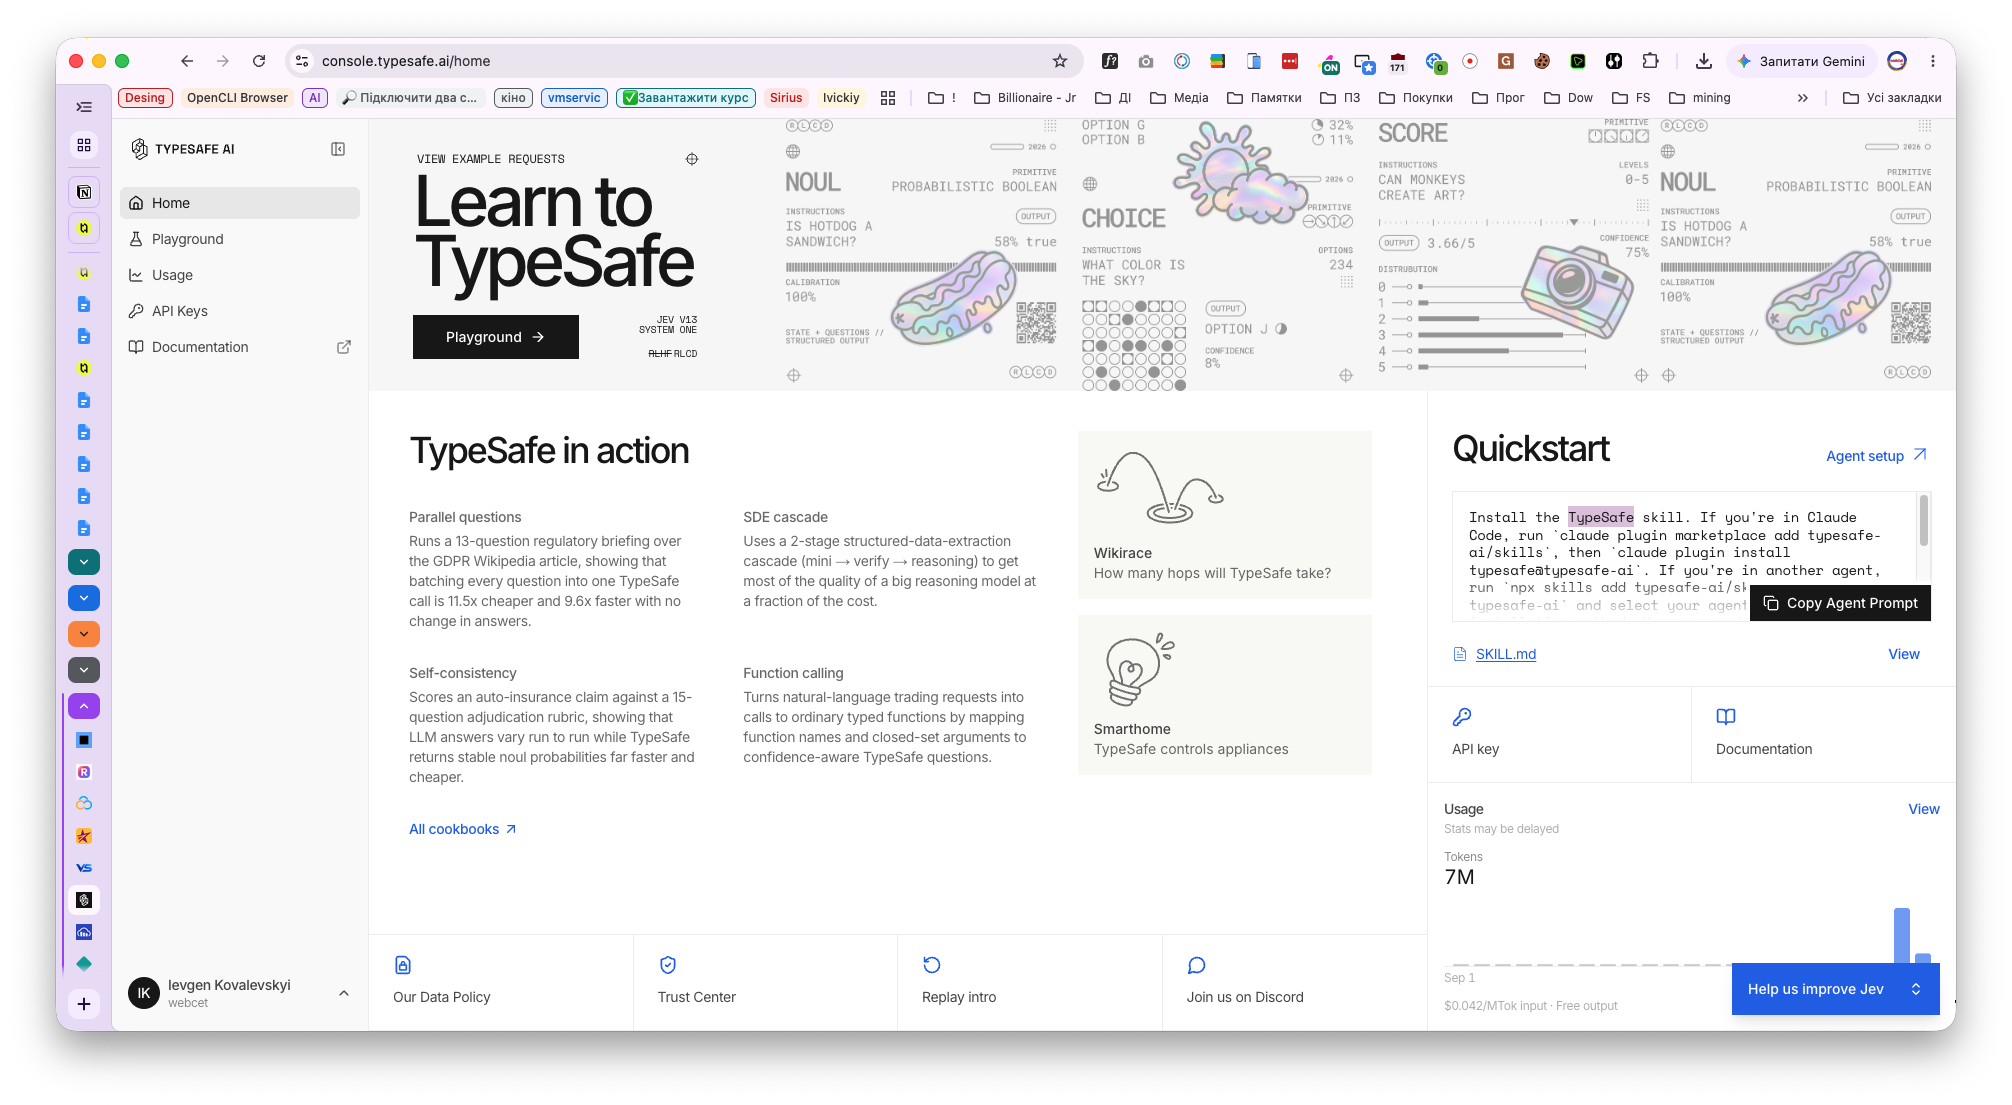
Jev — флагманська System One модель TypeSafe. Вона отримує описаний стан і повертає структуровану відповідь: вибір класу, оцінку або ймовірність. Вона не пише статті, код чи пояснення свого міркування. Так TypeSafe описує System One.
Різниця зі звичайною мовною моделлю проста. Сильна LLM добре розмовляє, пише і збирає думку з нуля. Jev працює тоді, коли відповідь уже треба втиснути в форму.
Наприклад, для кожного рядка у вас є не запит «що ти про це думаєш?», а конкретне питання: це цільова заявка, тепла чи шум? Чи цей відгук треба передати менеджеру? Чи ця відповідь іншої моделі містить вигаданий факт?
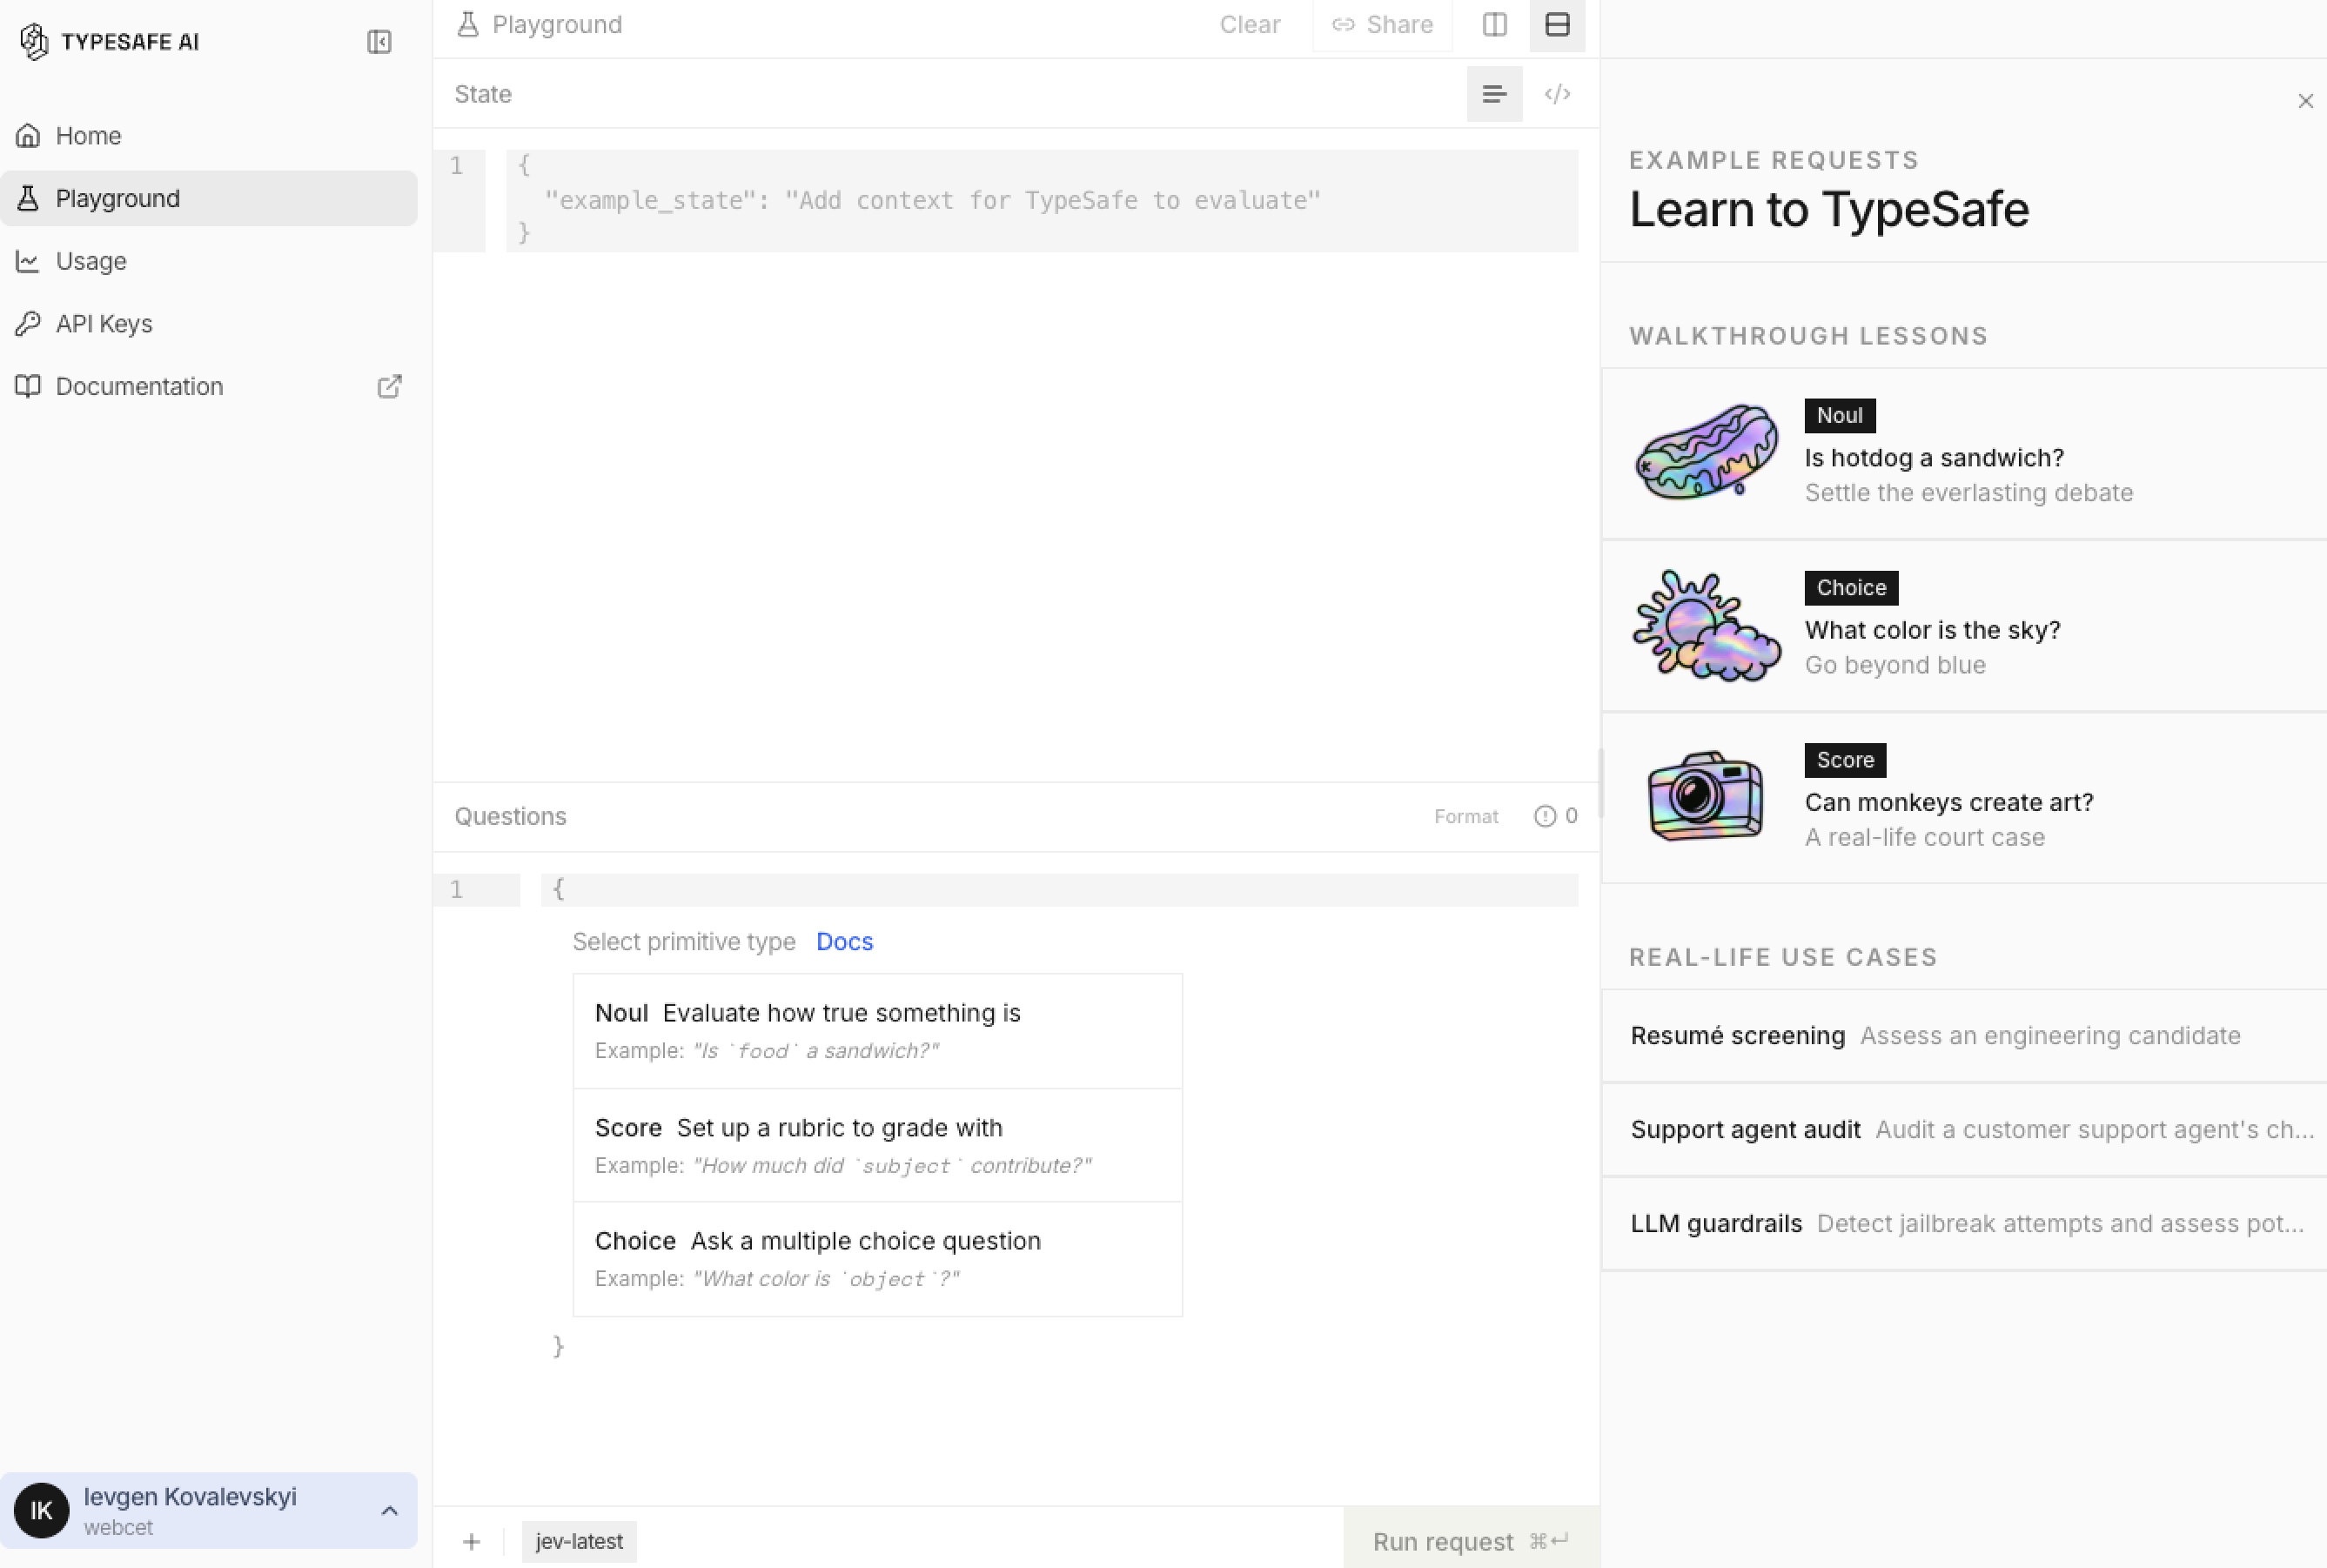
У TypeSafe є три базові примітиви:
- Choice — вибір одного варіанта із заданого набору.
- Score — оцінка за впорядкованою шкалою.
- Noul — так/ні з імовірністю того, що відповідь «так».
Для Choice і Score видно також confidence. Низька впевненість не означає, що модель «погана». Часто це знак, що сам випадок неоднозначний або ви ще не описали межу між класами. Про примітиви · про confidence.
Де це має сенс
Не там, де ви хочете красивий текст. І не там, де рішення існує у двох рядках звичайного коду.
Jev варто діставати, коли однотипних записів уже багато, а правило можна пояснити людині. Заявки: гаряча, тепла, нецільова. Відгуки: скарга, питання, подяка. Заголовки: можна публікувати чи треба переписати. Відповіді AI: факт підтверджено, вигадано або недостатньо даних.
У своєму процесі я використовую цей підхід і для вибору потрібного skill перед нетривіальною задачею, і для масових семантичних перевірок. Сенс не в тому, щоб віддати рішення «магічній моделі». Сенс у тому, щоб один раз чітко задати правило, перевірити його, а потім не повторювати однакову ручну роботу для кожного рядка.
Спочатку калібрування, потім масив
Найнебезпечніший момент тут не запуск. Найнебезпечніший момент — думка, що якщо питання звучить зрозуміло для вас, воно вже зрозуміле моделі.
Нормальний перший запуск виглядає так:
- Виписати одне рішення, яке повторюється в кожному рядку.
- Описати класи так, щоб вони не перетиналися.
- Розмітити руками 30–60 різних прикладів.
- Прогнати їх як контрольну вибірку.
- Подивитися, де правило не спрацювало, і уточнити саме правило.
- Лише тоді запускати весь масив та окремо переглядати прикордонні випадки.
Це не бюрократія. Без ручної вибірки ви не знаєте, чи модель помиляється, чи ви самі не визначили, що вважаєте правильною відповіддю.
Коротка історія з практики. Я взяв тестову вибірку пошукових термінів для умовної доставки води і попросив Jev визначати намір фрази та ризик мінус-слова. На 30 розмічених прикладах перша версія правил дала 83,33% і 73,33%. Друга стала кращою, але одна межа все ще була розмита. Після того як я додав пріоритети й приклади для прикордонних запитів, третя версія дала 93,33% і 100% на цій контрольній вибірці.
Цінність цього прикладу не в Google Ads. Він показує звичайну річ: якщо результат не збігається з вашим рішенням, не треба робити вигляд, що «майже нормально». Треба переписати правило і ще раз перевірити. У роботі з реальним звітом пошукових термінів це може бути частиною аудиту Google Ads, але сам принцип такий самий для заявок, відгуків і будь-якої іншої масової черги.
Людина не зникає з процесу
Після прогону у вас не з’являється дозвіл автоматично змінювати все підряд. З’являється впорядкований список рішень і окрема черга для сумнівних випадків.
Людина задає класи, розмічає контрольні приклади, дивиться на confidence і вирішує, що робити з результатом. Jev знімає монотонне повторення. Відповідальність він не забирає.
Це особливо важливо там, де ціна помилки висока: гроші, репутація, клієнтські дані. Дані без дозволу клієнта не треба передавати сторонньому сервісу. А там, де одне неправильне «так» може нашкодити, людина лишається останньою перевіркою.
Коли Jev не підходить
Не для трьох записів, які простіше прочитати самому. Не для текстів, розрахунків або стратегії. Не для задачі, де ви не можете пояснити, що саме є правильною відповіддю.
І не для процесу, де бізнес-правило вже простіше, дешевше й надійніше записати звичайним кодом.
Jev не замінює сильну модель і не робить AI «безкоштовним мозком для всього бізнесу». Він корисний на вузькій ділянці: багато разів поспіль сказати «це / не це» за правилом, яке людина вже перевірила.
Часті питання
Чим Jev відрізняється від звичайної LLM?
Звичайна LLM пише, пояснює і веде розмову. Jev повертає визначене структуроване рішення для кожного однотипного запису: клас, оцінку або ймовірність.
Чи можна запускати Jev без людини?
Можна автоматизувати повторюваний прогін після калібрування. Але людина має задати правило, перевірити приклади й лишити собі рішення щодо прикордонних або ризикових випадків.
Як почати без великого проєкту?
Візьміть одну чергу, де вже є десятки схожих записів. Сформулюйте один вузький критерій і вручну розмітьте 30–60 прикладів. Якщо правило не тримається на цій вибірці, не масштабуйте його.
Коли краще не використовувати Jev?
Коли задача одинична, коли треба написати новий текст, коли правило вже простіше реалізувати кодом або коли ціна помилки вища за вигоду від автоматизації.
Як отримати доступ до Jev
Якщо хочете спробувати Jev у своїй задачі, напишіть мені через контакти на сайті і вкажіть, що Вам потрібен промокод та коротка інструкція зі встановлення TypeSafe/Jev. Я надішлю актуальні умови доступу окремо. Не публікуйте API-ключі або інші секрети у відкритому вигляді.
Базовий порядок такий: встановити підтримуване середовище TypeSafe, додати доступ за офіційною інструкцією, створити вузьке правило для одного типу рішень, вручну перевірити контрольну вибірку і лише потім запускати масовий прогін. Актуальна документація — у TypeSafe Agent Skill.
У Google Ads це може виглядати так: у рекламному кабінеті спочатку відкривають звіт Пошукові терміни, експортують рядки за потрібний період і передають Jev не весь акаунт, а лише необхідні поля — сам термін, кампанію, групу, покази та витрати. Далі людина задає класи, наприклад «цільовий запит», «сумнівний» і «мінус-слово», розмічає контрольні приклади, а після прогону перевіряє низьку впевненість перед будь-якою зміною ключових слів або мінус-слів.