Когда AI нужен не для разговора
Есть задачи, где не нужен новый ответ каждый раз. Нужно много раз принять одно и то же небольшое решение: эта заявка горячая или нет, этот отзыв — жалоба или вопрос, эта фраза подходит категории или нет.
Человек может пройти такой список вручную. На десятой записи правила ещё понятны. На двухсотой они начинают немного плыть. Один пограничный случай кажется похожим на предыдущий, другой вдруг хочется оценить по другому критерию.
Именно здесь мне интересен Jev. Не как ещё один чат, которому каждый раз нужно объяснять контекст. А как узкий судья для потока однотипных записей.
Что такое Jev без обёртки
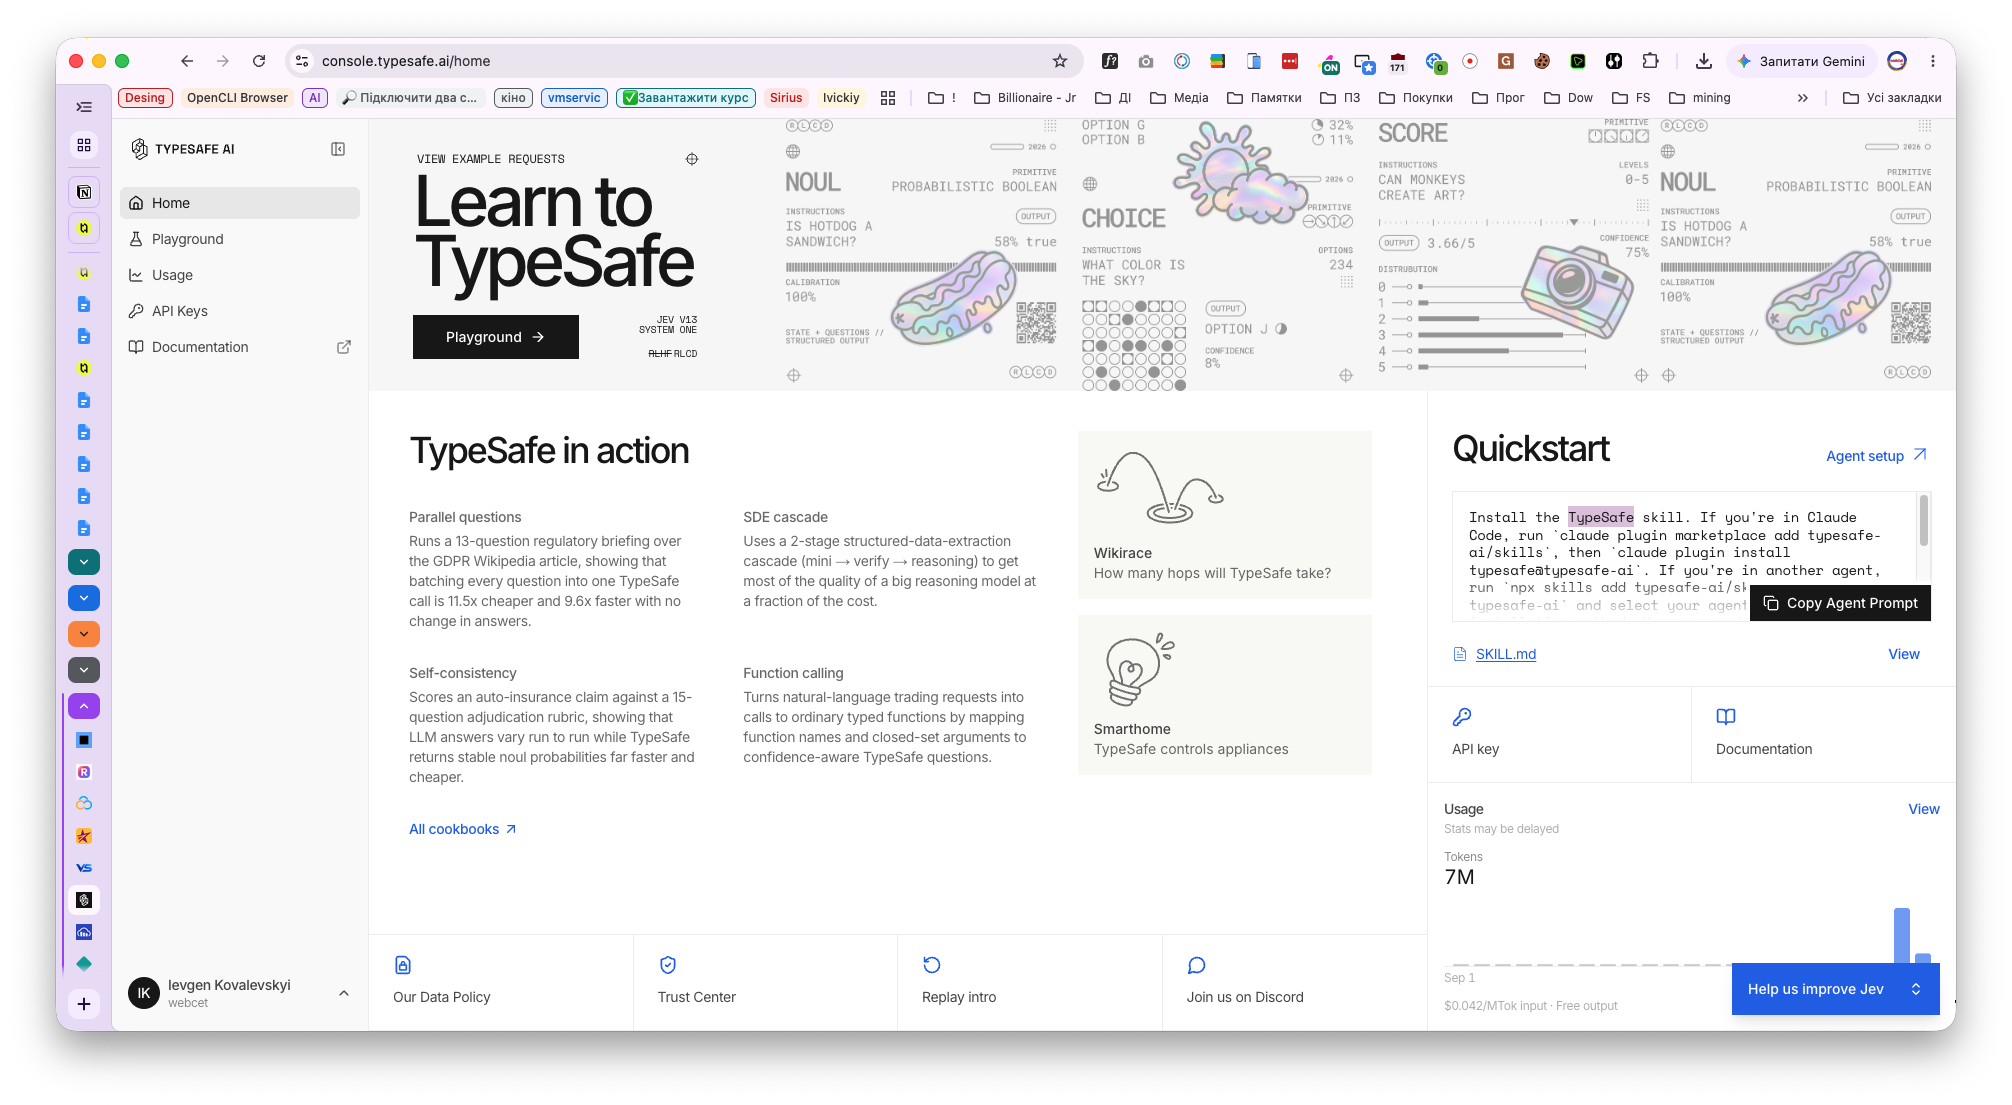
Jev — флагманская System One модель TypeSafe. Она получает описанное состояние и возвращает структурированный ответ: класс, оценку или вероятность. Она не пишет статьи, код или объяснение своего рассуждения. Так TypeSafe описывает System One.
Разница с обычной языковой моделью проста. Сильная LLM умеет разговаривать, писать и собирать мысль с нуля. Jev работает там, где ответ нужно поместить в заданную форму.
Вопрос для каждой строки не «что ты об этом думаешь?», а конкретный: эта заявка целевая, тёплая или шум? Этот отзыв нужно передать менеджеру? В этом ответе другой модели есть выдуманный факт?
У TypeSafe есть три базовых примитива:
- Choice выбирает один вариант из заданного набора.
- Score оценивает состояние по упорядоченной шкале.
- Noul отвечает да/нет с вероятностью того, что ответ «да».
Для Choice и Score также видно confidence. Низкая уверенность не значит, что модель плохая. Часто это сигнал, что сам случай неоднозначен или граница между классами ещё не описана. Примитивы TypeSafe · confidence.
Где это имеет смысл
Не там, где нужен красивый текст. И не там, где обычное правило в коде решит задачу в две строки.
Jev стоит доставать, когда похожих записей уже много, а правило можно объяснить другому человеку. Заявки: горячая, тёплая, нецелевая. Отзывы: жалоба, вопрос, благодарность. Заголовки: можно публиковать или нужно переписать. Ответы AI: факт подтверждён, выдуман или данных недостаточно.
В своём процессе я использую этот подход и для выбора нужного skill перед нетривиальной задачей, и для массовых семантических проверок. Смысл в том, чтобы один раз чётко задать правило, проверить его и не повторять одинаковую ручную работу для каждой строки.
Сначала калибровка, потом весь массив
Самый рискованный момент здесь не запуск. Самый рискованный момент — мысль, что вопрос уже понятен модели, потому что он понятен вам.
- Определить одно решение, которое повторяется для каждой записи.
- Описать классы так, чтобы они не пересекались.
- Разметить руками 30–60 разных примеров.
- Прогнать их как контрольную выборку.
- Посмотреть, где правило не сработало, и уточнить само правило.
- Только потом запускать весь массив и отдельно просматривать пограничные случаи.
Без ручной выборки вы не знаете, ошибается модель или вы сами не определили правильный ответ.
Короткая история из практики. Я взял тестовую выборку поисковых терминов для условной доставки воды и попросил Jev определять намерение фразы и риск добавления минус-слова. На 30 размеченных примерах первая версия правил дала 83,33% и 73,33%. Вторая стала лучше, но одна граница всё ещё была размытой. После того как я добавил приоритеты и примеры для пограничных запросов, третья версия дала 93,33% и 100% на этой контрольной выборке.
Ценность примера не в Google Ads. Он показывает обычную вещь: если результат расходится с вашим решением, «почти нормально» — не нормально. Нужно переписать правило и проверить ещё раз. В работе с реальным отчётом поисковых терминов это может быть частью аудита Google Ads, но сам принцип тот же для заявок, отзывов и любой другой массовой очереди.
Человек не исчезает из процесса
После прогона у вас не появляется разрешение автоматически менять всё подряд. Появляется упорядоченный набор решений и отдельная очередь для сомнительных случаев.
Человек задаёт классы, размечает контрольные примеры, смотрит на confidence и решает, что делать с результатом. Jev снимает монотонную сортировку. Ответственность он не забирает.
Это особенно важно там, где цена ошибки высока: деньги, репутация, клиентские данные. Не стоит передавать данные внешнему сервису без разрешения клиента. Там, где одно неверное «да» может навредить, человек остаётся последней проверкой.
Когда Jev не подходит
Не для трёх записей, которые быстрее прочитать самому. Не для текстов, расчётов или стратегии. Не для задачи, где вы не можете объяснить, что именно считается правильным ответом.
И не для процесса, где бизнес-правило уже проще, дешевле и надёжнее записать обычным кодом.
Jev не заменяет сильную модель и не делает AI «бесплатным мозгом для всего бизнеса». Он полезен на узком участке: много раз подряд сказать «это / не это» по правилу, которое человек уже проверил.
Частые вопросы
Чем Jev отличается от обычной LLM?
Обычная LLM пишет, объясняет и ведёт разговор. Jev возвращает определённое структурированное решение для каждой похожей записи: класс, оценку или вероятность.
Можно ли запускать Jev без человека?
Повторяющийся прогон можно автоматизировать после калибровки. Но человек должен задать правило, проверить примеры и оставить за собой решения по сомнительным или рискованным случаям.
Как начать без большого проекта?
Возьмите одну очередь, где уже есть десятки похожих записей. Сформулируйте один узкий критерий и вручную разметьте 30–60 примеров. Если правило не держится на этой выборке, не масштабируйте его.
Когда лучше не использовать Jev?
Когда задача единичная, когда нужно написать новый текст, когда правило проще реализовать кодом или когда цена ошибки выше выгоды от автоматизации.
Как получить доступ к Jev
Если хотите попробовать Jev на своей задаче, напишите мне через контакты на сайте и укажите, что Вам нужен промокод и краткая инструкция по установке TypeSafe/Jev. Актуальные условия доступа я отправлю отдельно. Не публикуйте API-ключи и другие секреты в открытом виде.
Базовый порядок такой: установить поддерживаемое окружение TypeSafe, добавить доступ по официальной инструкции, создать узкое правило для одного типа решений, вручную проверить контрольную выборку и только потом запускать массовый прогон. Актуальная документация — в TypeSafe Agent Skill.
В Google Ads это может выглядеть так: в рекламном кабинете открыть отчёт Поисковые запросы, выгрузить строки за нужный период и передать Jev только необходимые поля — сам запрос, кампанию, группу объявлений, показы и расходы. Затем человек задаёт классы, например «целевой запрос», «сомнительный» и «минус-слово», размечает контрольные примеры и проверяет результаты с низкой уверенностью перед изменением ключевых слов или минус-слов.